Showing posts with label R. Show all posts

March 28, 2019


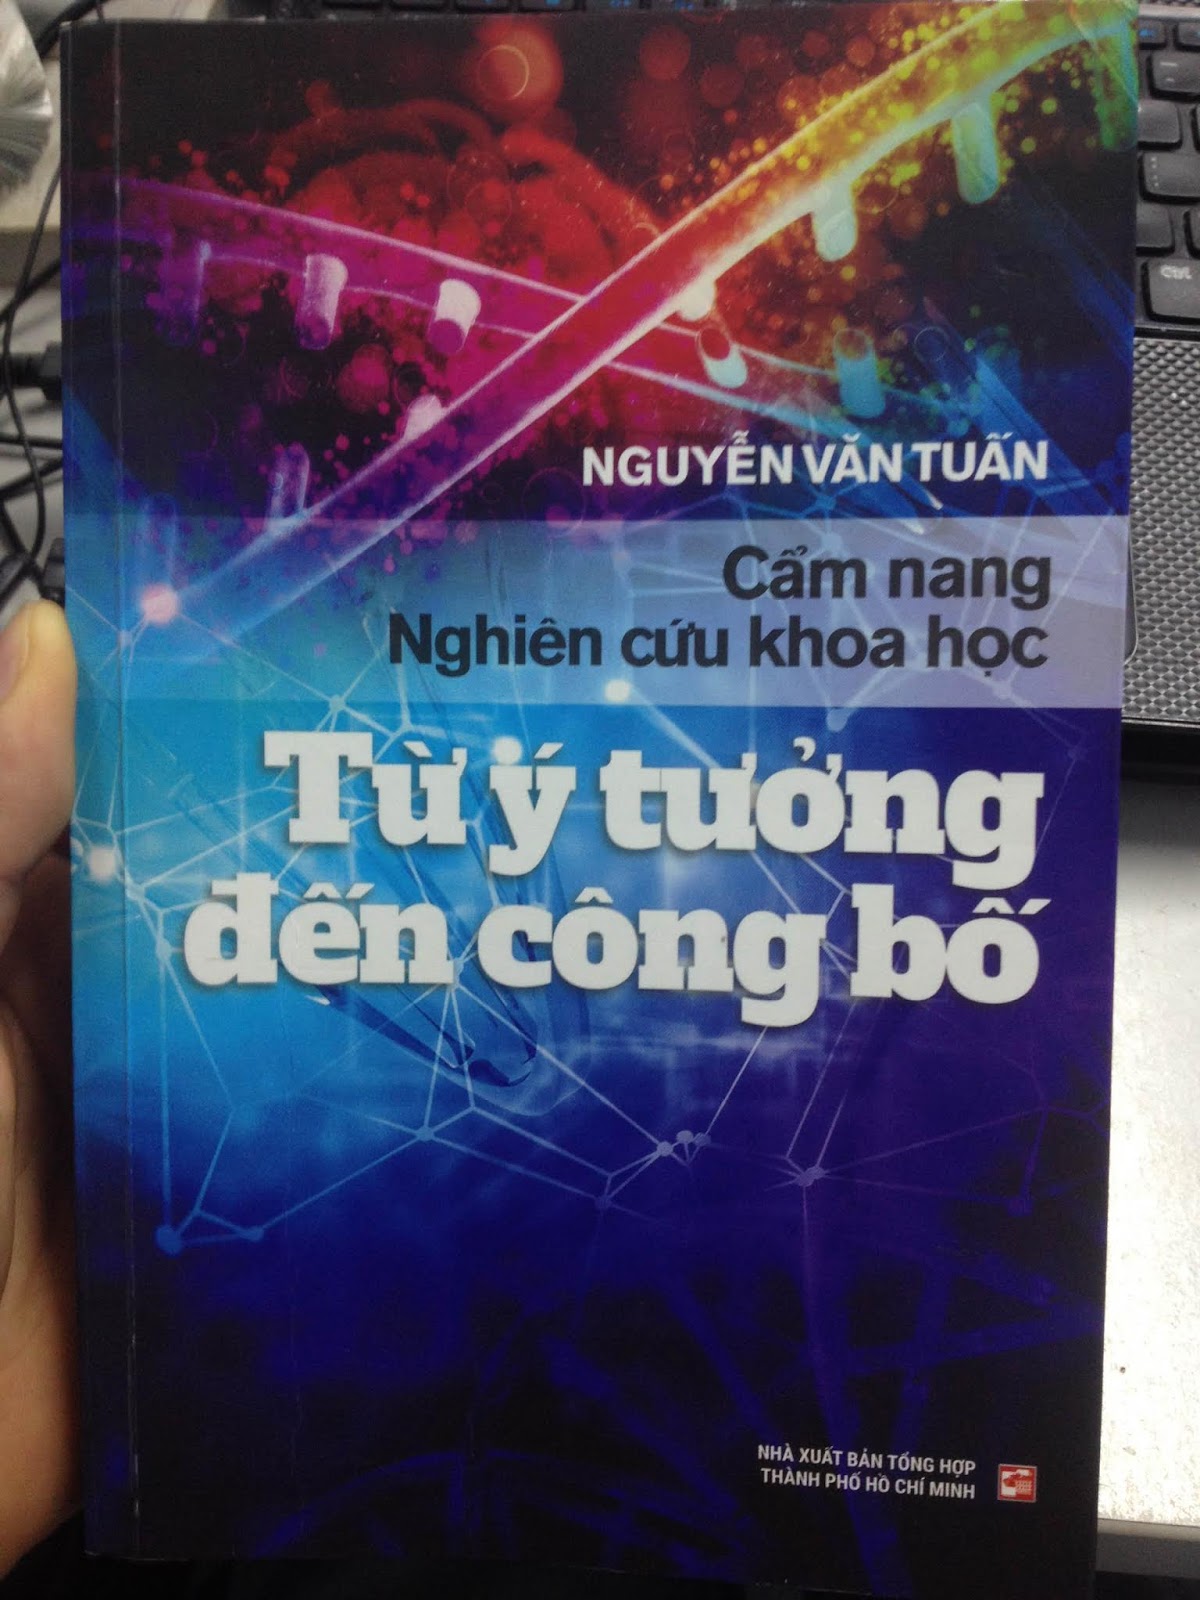
Trong cái note này mình xin mạn phép tác giả cuốn sách (GS Nguyễn Văn Tuấn - UNSW Sydney) và Nxb Tổng hợp TP HCM xin được giới thiệu tới bạn đọc cuốn sách hay về nghiên cứu khoa học chung, với tựa đề: “Cẩm nang Nghiên cứu khoa học - Từ ý tưởng đến công bố” (1). Như các cuốn sách khác, mỗi khi có cuốn mới của tác giả xuất bản tại Việt Nam là mình sớm sắm (tậu) cho được, ngoài việc đọc, biết, và dần hiểu những thông tin được truyền tải qua mỗi bài viết, mỗi trang sách; quan trọng hơn cả là từ những thông tin rất hữu ích đó mình (ở góc độ cá nhân) bước đầu tìm hiểu, bắt chước, và thực hành theo.

“Qua 21 chương sách, tôi (tác giả) sẽ giải đáp những câu hỏi như: bắt đầu nghiên cứu khoa học từ đâu, ý tưởng nghiên cứu xuất phát từ nguồn nào, phương pháp nghiên cứu ra sao, và công bố kết quả nghiên cứu ở đâu; và quan trọng hơn cả là những ví dụ thực tế giúp bạn đọc hiểu rõ hơn về qui trình nghiên cứu khoa học” - Trích trang lời nói đầu cuốn sách (1).

Về những vấn đề liên quan đến Nghiên cứu khoa học - Từ ý tưởng đến công bố, cuốn cẩm nang giới thiệu lần lượt các vấn đề của Nghiên cứu khoa học, từ câu hỏi tại sao phải nghiên cứu khoa học, thế nào là nghiên cứu khoa học, ý tưởng nghiên cứu khoa học từ đâu, cách tiếp cận như thế nào, cái mới trong khoa học… đến chọn mô hình nghiên cứu, thiết kế nghiên cứu; cỡ mẫu, tính đại diện trong nghiên cứu, thiết kế bộ câu hỏi thu thập dữ liệu; phân tích dữ liệu, diễn giải kết quả nghiên cứu; nguyên tắc trong việc soạn một bài báo khoa học…. và vấn đề thời sự trong thời gian gần đây là “huyền thoại con số 30 - cỡ mẫu, và trị số P trong nghiên cứu khoa học - khi mới đây Nature kêu gọi hạn chế sử dụng trị số P (dẫn theo facebook của GS Nguyễn Văn Tuấn). Những thông tin rất hữu ích đó mạn phép không dám nhàm bàn nhiều, mà chỉ dám dẫn lời để giới thiệu tới ai đó quan tâm đến những vấn đề có liên quan đến cuốn sách.

Một lần nữa người viết xin mạn phép được giới thiệu cuốn sách hay, hữu ích đến ai quan tâm đến vấn đề nghiên cứu khoa học nói chung để tự tìm hiểu, bắt chước, tập tành, và thực hành, vận dụng vào trong thực tiễn, công việc, đặc biệt là trong công cuộc nghiên cứu khoa học vốn còn nhiều nhiêu khê như hiện nay (nhận xét cảm tính của cá nhân người viết). Qua đó, dần thay đổi cách nhìn nhận, tiếp cận, và thực hành sao cho hướng tới những chuẩn mực chung của Nghiên cứu khoa học theo đúng nghĩa của nó. Qua đây, bản thân không dám “khoe”, hay “lên lớp” ai về vấn đề gì cả, dù là nhỏ nhất; bản thân chỉ thấy cuốn sách hay, ý nghĩa nên viết một vài dòng cảm nhận và lưu lại làm kỷ niệm.
Xin trân trọng!


(1) Nguyễn Văn Tuấn (2018). Cẩm nang Nghiên cứu khoa học - Từ ý tưởng đến công bố. Nxb Tổng hợp TP HCM, 398 trang.

June 08, 2017

Như có đề cập đến ở một vài cái note trước, về một vài câu chuyện nho nhỏ có liên quan đến việc ứng dụng R trong phân tích dữ liệu. Trong phạm vi cái note này, là câu chuyện liên quan đến cái biểu đồ mà mình có ứng dụng R để vẽ, với mục đích tối đa hóa các thông tin trên một biểu đồ thay vì phải tách làm hai hay sử dụng những biểu đồ đơn giản từ excel.

Tương tự như trong một vài cái biểu đồ mà mình có vẽ giúp một bạn trong luận án thạc sĩ năm 2015 (Trường ĐH NLTN). Cũng là “cái biểu đồ”, giáo viên hướng dẫn chưa biết (chưa nghe nói về R) ý nghĩa của cái biểu đồ này, trong khi học viên chưa giải thích được (do được sự trợ giúp) nên cô phán rằng “bỏ đi, quá rắc rối”. Trong trường hợp này cũng vậy, trong hội đồng nghiệm thu đề tài cấp Nhà nước, mình cũng sử dụng R với sự hỗ trợ của gói ggplot2, gridExtra và ggrepel để vẽ biểu đồ tương quan lồng ghép với biểu đồ phân bố. Tuy nhiên, khi cô nhận xét trước hội đồng, đặc biệt liên quan đến biểu đồ, cô nói “lần đầu tiên tôi nhìn thấy cái biểu đồ như vậy”. Và, “tôi không hiểu hai cái đường màu đỏ này có ý nghĩa gì”?  (hình dưới). Là người trực tiếp vẽ biểu đồ, tôi hiểu cái ý của cô. Nhưng tôi cũng chẳng thể đứng dậy giải thích ý nghĩa của cái biểu đồ trước mặt các thành viên hội đồng như vậy. Thôi thì. Ngồi mỉm cười trừ.

Đúng là nhận xét của cô không sai. Cái thiếu sót của tôi là chưa sử dụng hết ngôn từ để làm sáng tỏ hết ý nghĩa của biểu đồ cho người đọc rõ. Qua đây mình cũng phải nhìn nhận lại chính mình trong việc hành văn để diễn giải ý nghĩa của những biểu đồ. Không thể “để đấy và không nói gì cả”. Thực ra, biểu đồ nào mình cũng có nói ít nhiều, chứ không kiểu “để đấy”, ai hiểu gì thì hiểu. Có thể mình chưa nói hết. Nên ít nhiều làm khó cho người đọc, đặc biệt là những ai chưa quan tâm nhiều về R.

Nực cười hơn. Không biết có phải một thành viên hội đồng hơi cường điều hóa không, khi thầy nhận xét một câu “tôi phải dùng kính lúp để soi các biểu đồ”. Phải chăng thầy có tuổi nên mắt hơi kém. Nhưng không. Thầy vẫn trung tuổi, có đến nỗi nào đâu? Tuy nhiên, qua đó nhận xét như vậy mình cũng phải nhìn nhận lại mình. Bởi đó là cái thiếu sót của mình trong việc chưa làm rõ hết được ý nghĩa của biểu đồ cũng như chưa làm rõ hơn các biểu đồ trong báo cáo.

Thôi thì “nhận dạng nhầm lẫn của người khác cũng có nghĩa là nâng cao kĩ năng nhận dạng nhầm lẫn của chính mình” [1]. Thực sự, đó là một trong những trải nghiệm trên tinh thần cầu thị mình không thể không nhìn nhận lại chính mình. Bởi, “nếu dùng ngôn ngữ không đúng, thì những gì được phát biểu sẽ bị hiểu sai; nếu những gì phát biểu bị hiểu sai, thì những gì cần phải làm sẽ không thực hiện được, và những gì không thực hiện được, đạo đức và nghệ thuật sẽ trở nên tồi tệ hơn” - Khổng Tử [1]. Dù ít dù nhiều thông qua những góp ý như vậy mình mới rút ra được nhiều bài học trong việc xử lý, trình bày dữ liệu, đặc biệt là thể hiện dữ liệu bằng các hình, biểu đồ. Tuy nhiên, việc sử dụng R để tạo nên một vài biểu đồ có ý nghĩa không đơn giản chút nào, chưa kể đến việc phải đầu tư suy nghĩ, mất thời gian... mà ngay cả những người đi trước (chắc quen sử dụng SPSS, Excel) cũng chưa tạo điều kiện để hiểu và chấp nhận cho.

===========================================
[1] Nguyễn Văn Tuấn (2013). Từ nghiên cứu đến công bố - Kỹ năng mềm cho nhà khoa học. Nxb Tổng hợp TP HCM, tr 31.

February 28, 2017

Hiện nay, việc ứng dụng R trong phân tích dữ liệu không còn mới ở Việt Nam, bởi cộng đồng sử dụng thống kê toán và R ngày càng lớn mạnh thông qua các workshop, các diễn đàn... hay các khóa đào tạo liên quan đến R. Tuy nhiên, sẽ là “rất mới” với những ai chưa được nghe tới, biết tới, đặc biệt là những lớp người đi trước (một số còn chẳng chấp nhận việc ứng dụng R trong phân tích, xử lý dữ liệu, vẽ các biểu đồ...). Trong phạm vi bài viết, mình xin được chia sẻ trường hợp việc mình ứng dụng R trong phân tích dữ liệu, đặc biệt là sử dụng để vẽ các hình, biểu đồ tương đối đẹp, khoa học... trong báo cáo tổng kết đề tài. Về biểu đồ mình có thể “tạm” khẳng định là đẹp, logic và khoa học và rất ít, các đề tài tương tự có được những hình, biểu đồ như vậy (giới hạn mà mình được biết tới).

Trong quá trình thực hiện đề tài cũng như tham khảo các báo cáo tổng kết đề tài ở các đơn vị khác, mình chưa thấy nhiều, thậm chí là không có đề tài ứng dụng R trong phân tích dữ liệu cũng như vẽ biểu đồ có liên quan. Đa phần là các hình vẽ từ Excel là chủ yếu, một vài từ các phần mềm thương mại như SPSS, Stata, SAS... Về liên quan đến việc ứng dụng R mình có thể kể ra đây một vài trường hợp như sau:

“Phần mềm R là gì, nếu hay anh có thể giới thiệu cho hội đồng cũng như mọi người biết, ứng dụng...”. Đó là lời một thầy ngồi trong hộ đồng chấm luận văn thạc sĩ khoa học về Biến đổi khí hậu năm 2015 (Đại học quốc gia HN) nhận xét. Khi đó, mình có vẽ giúp mấy cái biểu đồ (biểu đồ tương quan với nhãn) bằng R cho một anh đang làm luận văn thạc sĩ. Thực ra, mình vẽ giúp và cũng không cung cấp các thông tin có liên quan, nên anh ấy cũng chẳng biết thế nào để giải thích cho thầy cũng như hội đồng rõ hơn về R.

Rồi mình có giúp một bạn cũng đang trong thời gian làm luận văn thạc sĩ khoa học lâm nghiệp năm 2015 (Đại học NL Thái Nguyên), việc xử lý số liệu, phân tích dữ liệu và vẽ biểu đồ hoàn toàn bằng R. Nên khi bảo vệ luận án các thầy trong hội đồng cũng chẳng biết R là gì luôn, đặc biệt là cô giáo hướng dẫn khi được hỏi về các biểu đồ tương quan có những ý nghĩa như thế nào? học viên không giải thích được (do mình vẽ giúp) nên cô phán rằng “bỏ đi, quá rắc rối”. Đó là những gì mình được nghe lại sau khi bạn ấy đến gặp giáo viên hướng dẫn xin ý kiến về đề tài luận án.

Trường hợp gần đây nhất (cuối năm 2016), là mình trực tiếp xử lý, phân tích và vẽ các loại biểu đồ bằng R trong báo cáo tổng kết đề tài. Khi chuẩn bị hội đồng, mình có in mấy cuốn đi xin ý kiến của các nhà khoa học (cây đa cây đề trong các lĩnh vực có liên quan) về nội dung, chất lượng của báo cáo. Khi đến xin ý kiến phản hồi, đa phần các chuyên gia đều có một góp ý chung là “bắt phải dẫn nguồn các hình, các biểu đồ”. Phần lớn các biểu đồ các chuyên gia chưa thấy hoặc rất ít trong các báo cáo khoa học hay các luận án nghiên cứu, đặc biệt là khi vẽ biểu đồ các tựa đề (title), nhãn cho trục trung (ylab), trục hoành (xlab) mình sử dụng bằng tiếng Anh. Hơn nữa, do in đen trắng nên các chuyên gia đều cho rằng mình và nhóm viết báo cáo coppy hình, biểu đồ (biểu đồ tương quan với nhãn, biểu đồ hộp boxplot, biểu đồ kiểm tra hậu định trong phân tích phương sai, biểu đồ xây dựng mô hình tuyếntính bằng Bayesian Model Average...) từ đâu đó, nên bắt phải trích nguồn tài liệu tham khảo.

Khi được giải thích, mình khẳng định trong báo cáo 100% các hình là do nhóm thực hiện (cá nhân) vẽ và xuất phát từ nguồn số liệu điều tra, theo dõi đo đếm của đề tài. Có Bác hỏi tiếp, vậy tựa đề mỗi hình không nên viết tiếng Anh. Mình cũng phải giải thích, cháu có để tiếng Việt nhưng cháu chưa biết cách khắc phục khi để tựa đề trong các hình bằng tiếng Việt đều bị lỗi. Mình có dở hình mà mình để tiếng Việt và bị lỗi làm dẫn chứng. Và, rồi Bác cũng không ý kiến thêm về các hình vẽ, biểu đồ nữa.

Cũng phải thú thực một điều, việc vẽ các hình, biểu đồ đẹp, khoa học, logic là rất tốt (tự khen một cái), nhưng việc hiểu và giải thích các ý nghĩa của các biểu đồ không phải đơn giản. Và, bản thân mình cũng chưa hiểu và giải thích hết các ý nghĩa của biểu đồ bằng các lời văn, câu từ sao cho hợp lý. Nên dẫn đến việc nhiều người nhầm tưởng mình đi coppy paste các biểu đồ đó trong báo cáo.

Ngày bảo vệ trước hội đồng, mình sử dụng đa số các hình vẽ, biểu đồ trong báo cáo và cố gắng giải thích ý nghĩa các hình, các biểu đồ mà khả năng có thể. Các thầy trong hội đồng đều chăm chú theo dõi các hình, các biểu đồ thật đẹp, sinh động qua các slide mà mình đang trình chiếu bằng laser pointer. Trong quá trình nhận xét phản biện của các thầy trong hội đồng đều khen về cách trình bày cũng như hình vẽ, biểu đồ rất sinh động. Có thầy cũng thú thực khi xem hình trong báo cáo (in đen trắng) rất khó coi và khó hiểu, nhưng khi nghe trình bày và giải thích qua các slide thì thấy rất có ý nghĩa và thú vị. Đó là một trong những niềm vui đối với “riêng” cá nhân mình khi bước đầu tìm hiểu, ứng dụng R trong xử lý, phân tích và vẽ các biểu đồ có liên quan trong các nghiên cứu.


Trên đây là một vài kỷ niệm nho nhỏ khi mình ứng dụng phần mềm R (phần mềm mở) trong xử lý, phân tích và vẽ các hình, biểu đồ có liên quan trong các báo cáo nghiên cứu. Việc ứng dụng R cũng như những khích lệ trong việc sử dụng R trong phân tích dữ liệu nghiên cứu là rất cần thiết, đặc biệt là từ phía các chuyên gia, các nhà khoa học đi trước, ít hoặc có những hạn chế trong việc tiếp cận R ngày nay. Tuy nhiên, không phải ai cũng thích thay đổi khi bản thân mình chưa được nghe hay biết tới, ngay cả những người trẻ như mình bây giờ.

January 24, 2017

T
rong phạm vi bài viết, mình tập tành chút trong việc xây dựng mô hình tuyến tính bằng Bayesian Model Average (BMA). Bài viết được áp dụng trên cơ sở giáo trình “Phân tích dữ liệu với R - Nguyễn Văn Tuấn” (trang 186-188). Theo đó, phép tính BMA tìm tất cả các mô hình khả dĩ và trình bày kết quả của các mô hình được xem là “tối ưu” nhất về lâu dài. Tiêu chuẩn tối ưu cũng dựa vào giá trị Akaike Information Criterion (AIC).

Trước tiên, để sử dụng phép tính BMA, chúng ta cần tải và cài package BMA.
> library(BMA)
Về dữ liệu:
> sk_kll
     d    h   dt scanh   re than canh   la
1 2.16 0.90 0.93     5 0.35 0.12 0.17 0.35
2 5.25 2.10 2.15    14 3.34 1.34 1.10 2.20
3 4.17 1.84 2.01    15 2.25 0.75 0.67 0.95
..........................................
..........................................

Trước tiên, chúng ta cần tạo ra một ma trận chỉ gồm các biến độc lập. Trong data (sk_kll) chúng ta có các biến d (đường kính gốc), h (chiều cao cây), dt (đường kính tán) và scanh (số cành dài trên 50cm)... của cây Keo lá liềm trồng trên đất cát vùng ven biển các tỉnh Bắc Trung bộ. Biến y (biến tiên đoán), có thể là (sinh khối rễ, sinh khối thân, sinh khối cành và sinh khối lá). Mục đích của phép tính này, là tiên đoán sinh khối bộ phận thân cây Keo lá liềm theo một số chỉ tiêu sinh trưởng (d, h, dt, scanh...).

Bước tiếp theo, chúng ta tạo ra một data frame mới gồm các biến độc lập (d, h, dt và scanh).
> biendoclap=sk_kll[,c(1:4)]
Lệnh trên có nghĩa, tạo ra data frame mới gồm 4 biến (d, d, dt và scanh) với tất cả các dòng dữ liệu.
Đối với biến tiên lượng (áp dụng cho từng biến tiên lượng). Cụ thể:
> re=sk_kll[,c(5)]
> than=sk_kll[,c(6)]
> canh=sk_kll[,c(7)]
> la=sk_kll[,c(8)]
1. Tiên lượng cho biến sinh khối rễ
Bây giờ chúng ta đã sẵn sàng phân tích bằng phép tính BMA. Để phân tích hồi qui tuyến tính, chúng ta sử dụng hàm bicreg trong package BMA.

> re1=bicreg(biendoclap,re, strict=FALSE, OR=20)
> summary(re1)
Call:
bicreg(x = xvars, y = re, strict = FALSE, OR = 20)
  7  models were selected
 Best  5  models (cumulative posterior probability =  0.7413 ):
           p!=0    EV       SD   model 1    model 2    model 3 
Intercept  100.0  -1.91834  NaN   -1.74414   -1.72798   -1.72285
d           61.2   0.61783  NaN    0.96480    1.02960    1.07714
h           38.8   1.22103  NaN      .          .       -0.28197
dt          38.8   0.18728  NaN      .       -0.15695      .   
scanh       38.8  -0.06831  NaN      .          .          .                    
nVar                                 1          2          2   
r2                                 0.999      0.999      0.999 
BIC                              -19.62465  -18.52604  -18.52604
post prob                          0.224      0.129      0.129 
           model 4    model 5 
Intercept   -1.75410   -2.61290
d            0.99922      .   
h              .          .   
dt             .        5.16129
scanh       -0.01084   -0.36742                             
nVar           2          2   
r2           0.999      0.999 
BIC        -18.52604  -18.52604
post prob    0.129      0.129
Kết quả bên trên đưa ra 05 mô hình được đánh giá là tối ưu nhất cho mô hình tiên đoán sinh khối rễ thân cây Keo lá liềm.
Chúng ta có thể thể hiện kết quả trên qua biểu đồ dưới đây:

> imageplot.bma(re1)
Tương tự, cho việc tiên đoán cho các biến tiên lượng (sinh khối thân, cành và lá).
2. Tiên lượng cho sinh khối thân cây

> than1=bicreg(biendoclap,than, strict=FALSE, OR=20)
> summary(than1)
Call:
bicreg(x = xvars, y = than, strict = FALSE, OR = 20)
  8  models were selected
 Best  5  models (cumulative posterior probability =  0.625 ): 
           p!=0    EV      SD   model 1    model 2    model 3  
Intercept  100.0  -0.8168  NaN   -0.68873   -0.67005   -0.67005
d           50.0   0.3396  NaN    0.62034    0.79334    0.79334
h           62.5   0.8939  NaN      .       -1.02619   -1.02619
dt          50.0  -0.3971  NaN   -0.57119      .          .    
scanh       37.5  -0.0464  NaN      .          .          .                                                              
nVar                                2          2          2    
r2                                0.999      0.999      0.999  
BIC                             -18.52604  -18.52604  -18.52604
post prob                         0.125      0.125      0.125  
           model 4    model 5  
Intercept   -0.78377   -1.22190
d            0.50976      .    
h              .          .    
dt             .        2.63306
scanh       -0.03946   -0.22137                       
nVar           2          2    
r2           0.999      0.999  
BIC        -18.52604  -18.52604
post prob    0.125      0.125 
> imageplot.bma(than1)
3. Tiên lượng sinh khối cành

> canh1=bicreg(biendoclap,canh, strict=FALSE, OR=20)
> summary(canh1)
Call:
bicreg(x = xvars, y = canh, strict = FALSE, OR = 20)
  7  models were selected
 Best  5  models (cumulative posterior probability =  0.7143 ): 
           p!=0    EV       SD   model 1    model 2    model 3  
Intercept  100.0  -0.54887  NaN   -0.45181   -0.43983   -0.43983
d           57.1   0.27623  NaN    0.44565    0.55664    0.55664
h           57.1   0.38324  NaN      .       -0.65834   -0.65834
dt          42.9  -0.03839  NaN   -0.36644      .          .    
scanh       42.9  -0.03740  NaN      .          .          .                                                                 
nVar                                 2          2          2    
r2                                 0.999      0.999      0.999  
BIC                              -18.52604  -18.52604  -18.52604
post prob                          0.143      0.143      0.143  
           model 4    model 5  
Intercept   -0.51279   -0.83484
d            0.37471      .    
h              .          .    
dt             .        1.93548
scanh       -0.02532   -0.15903                             
nVar           2          2    
r2           0.999      0.999  
BIC        -18.52604  -18.52604
post prob    0.143      0.143 

> imageplot.bma(canh1)
4. Tiên lượng cho biến sinh khối lá

> summary(la1)
Call:
bicreg(x = xvars, y = la, strict = FALSE, OR = 20)
  7  models were selected
 Best  5  models (cumulative posterior probability =  0.7143 ): 
           p!=0    EV      SD   model 1   model 2   model 3   model 4 
Intercept  100.0  -1.1493  NaN   -0.7806   -0.7117   -1.1311   -2.0101
d           42.9   0.6460  NaN    1.4305    2.0686    1.0226      .   
h           57.1   2.4123  NaN      .      -3.7850      .         .   
dt          57.1  -1.4977  NaN   -2.1068      .         .       5.2823
scanh       42.9  -0.1348  NaN      .         .      -0.1456   -0.5105                                                                  
nVar                                2         2         2         2   
r2                                0.999     0.999     0.999     0.999 
BIC                             -18.5260  -18.5260  -18.5260  -18.5260
post prob                         0.143     0.143     0.143     0.143 
           model 5 
Intercept   -0.9351
d              .   
h            8.4853
dt          -6.8298
scanh          .                   
nVar           2   
r2           0.999 
BIC        -18.5260
post prob    0.143
> imageplot.bma(la1)

Trên đây mình có tập tành chút về áp dụng R hoặc tương tác với RStudio để xây dựng mô hình tuyến tính bằng Bayesian Model Average (BMA). Có thể tóm tắt các bước để tìm mô hình “tối ưu” bằng tiêu chuẩn BMA như sau:
> library(BMA)
> biendoclap=sk_kll[,c(1:4)]
> re=sk_kll[,c(5)]
> than=sk_kll[,c(6)]
> canh=sk_kll[,c(7)]
> la=sk_kll[,c(8)]
> re1=bicreg(biendoclap,re, strict=FALSE, OR=20)
> summary(re1)
> imageplot.bma(re1)

Quý bạn đọc cũng có thể tham khảo tại đây

December 29, 2016

S
au một thời gian vắng bóng. Giờ đây tôi sẽ quay lại với cái đam mê của mình, tức là “tập tành, bắt chước...” những mẹo hay có liên quan đến R. Thú thật. Trong thời gian vừa qua, do hơi bận rộn cho việc nghiệm thu nhiệm vụ cũng như công việc cuối năm. Thực ra, hiện giờ không phải mình rảnh cho lắm, tuy nhiên, vẫn cố gắng tìm hiểu, tập tành, bắt chước... rồi cùng trao đổi, chia sẻ với những ai quan tâm để cùng nhau học hỏi, tiến bộ hơn trong vấn đề ứng dụng R trong học tập, công việc, nghiên cứu.

Thú thực một điều. Khi ứng dụng R trong việc xử lý, phân tích cũng như vẽ các biểu đồ trong các báo cáo nghiên cứu. Nhiều người vẫn không tin đó là những hình vẽ, biểu đồ... mà chính người “chấp bút” tạo nên, đặc biệt những ai chưa nghe đến “R”. Cứ nghĩ là “cóp nhặt” đâu đó, mà còn không trích dẫn nguồn. Tuy nhiên, không hẳn mình đã có đủ khả năng hiểu hết về ý nghĩa của các hình, biểu đồ mà mình tạo ra, nên việc giải thích, diễn giải ý nghĩa của các biểu đồ còn nhiều hạn chế. Thực ra, đó càng là “động lực” cho mình tìm hiểu và muốn hoàn thiện hơn.


Trong thời gian vừa rồi, khi đi xin ý kiến các bác chuyên gia có liên quan đến chuyên môn cũng bị hỏi về vấn đề “hình vẽ, biểu đồ” lấy nguồn ở đâu mà không “trích nguồn”. Có lẽ, việc giải thích, diễn giải ý nghĩa của các biểu đồ thực sự sẽ là thách thức đối với cá nhân trong thời gian tới, đặc biệt trong các hội đồng nghiệm thu các nhiệm vụ (toàn những cây đa cây đề), trước nay chúng ta hay quen với các loại bản đồ đơn giản (excel, spss...). 

October 27, 2016

Bài viết này xuất phát từ nhận định cũng như câu hỏi của Thầy Emu Trần (Trần Bình Đà) khi mình có đăng mấy hình ảnh về biểu đồ hộp thể hiện một số chỉ tiêu sinh trưởng của cây Keo lá liềm được thử nghiệm ở các CTTN khác nhau. Khi đó mình cũng mới dừng lại ở việc phân tích thống kê đơn giản, tức là dừng lại ở việc kiểm sự khác biệt có ý nghĩa thống kê hay không giữa các CTTN về một số chỉ tiêu nghiên cứu, mà chưa đi sâu kiểm tra xem giữa các các công thức nào (so sách cặp đôi) có sự sai khác có ý nghĩa thống kê.

Trong phạm vi bài viết này, mình giới thiệu cách phân tích hậu định trong phân tích phương sai (soạn theo bài giảng của GS Nguyễn Văn Tuấn), vừa là để trả lời câu hỏi rất hữu ích và ý nghĩa của Thầy Emu Trần. Nhân đây cũng xin được gửi lời cảm ơn sâu sắc đến GS Nguyễn Văn Tuấn đã có những bài giảng, tài liệu... giới thiệu về R, nghiên cứu khoa học rất hữu ích và là người truyền lửa về nghiên cứu khoa học cho thế hệ sau, người luôn trăn trở cho nền giáo dục, khoa học nước nhà. Và được xin gửi lời cảm ơn về tất cả, không hẳn chỉ là câu hỏi rất chi là hữu ích của Thầy Emu Trần (Emu Trần Theo thầy thấy, kết quả trên của em không có sự khác biệt có ý nghĩa cho cả các công thức và ĐC. Kết quả TB của ĐC có cao hơn các CT, nhưng dao động của số liệu thì không cho thấy có sự khác biệt. Em thử phân tích hậu định bằng Kruskal xem sao) (trích từ facebook Emu Trần).

Trước tiên mình vẽ hình mà bữa trước mình có đăng và từ đó gợi mở ra nhiều điều.


Codes để vẽ hình như sau:


> Age1.2tp2=ggplot(data=Age1.2tp, aes(Age1.2tp$CTTN, y=stump_diameter))+ geom_boxplot(aes(fill=CTTN), outlier.colour="red", outlier.size=2.7)+ theme_bw()+ theme_classic()+ xlab("CTTN")+ ylab("tree height, m")+ggtitle("A. crassicarpa 14 months of age in Trieu Phong")+ geom_rangeframe()+ theme_tufte()+ scale_y_continuous(breaks=extended_range_breaks()(Age1.2$stump_diameter))+ theme(legend.position="top")+ coord_flip()
> Age1.2tp2

Kết quả kiểm tra thống kê:

Biểu đồ hộp trên cho ta cái nhìn tổng quan về chỉ tiêu sinh trưởng đường kính gốc của cây Keo lá liềm về một số thông tin như: Bách phân vị 75%, 50%, 25%, outlier (chấm đỏ)...

Kết quả cho CT3 như sau:

> summary(TP_CT3_1.2)
         Local          Age        CTTN     stump_diameter
 Cam_Duong  :  0   Min.   :1.2   CT 1:  0   Min.   :0.320 
 Le_Thuy    :  0   1st Qu.:1.2   CT 2:  0   1st Qu.:2.147 
 Trieu_Phong:110   Median :1.2   CT 3:110   Median :2.580 
                   Mean   :1.2   DC  :  0   Mean   :2.675 
                   3rd Qu.:1.2   DC  :  0   3rd Qu.:3.250 
                   Max.   :1.2              Max.   :4.650 
  tree_height     canopy_diameter   main_trunk     bough_50_cm  
 Min.   :0.3500   Min.   :0.500   Min.   :1.000   Min.   :0.000 
 1st Qu.:0.7000   1st Qu.:0.900   1st Qu.:2.000   1st Qu.:2.000 
 Median :0.9100   Median :1.140   Median :4.000   Median :2.000 
 Mean   :0.9543   Mean   :1.162   Mean   :3.555   Mean   :2.318 
 3rd Qu.:1.2000   3rd Qu.:1.350   3rd Qu.:5.000   3rd Qu.:3.000 
 Max.   :2.0000   Max.   :3.550   Max.   :8.000   Max.   :5.000 
   phan_than        song_chet stump_diameter_growth tree_height_growth
 Min.   :0.0000   Min.   :1   Min.   :0.270         Min.   :0.2900   
 1st Qu.:0.0000   1st Qu.:1   1st Qu.:1.792         1st Qu.:0.5800   
 Median :0.0000   Median :1   Median :2.150         Median :0.7600   
 Mean   :0.1273   Mean   :1   Mean   :2.229         Mean   :0.7958   
 3rd Qu.:0.0000   3rd Qu.:1   3rd Qu.:2.710         3rd Qu.:1.0000   
 Max.   :1.0000   Max.   :1   Max.   :3.870         Max.   :1.6700   
 canopy_diameter_growth  litter_fall   
 Min.   :0.4200         Min.   :0.0000 
 1st Qu.:0.7500         1st Qu.:0.1000 
 Median :0.9500         Median :0.1200 
 Mean   :0.9675         Mean   :0.1265 
 3rd Qu.:1.1300         3rd Qu.:0.1600 
 Max.   :2.9600         Max.   :0.2300 

Có thể diễn giải kết quả cho CT3 như sau: Chỉ tiêu đường kính gốc (bôi vàng), có 75% đối tượng cây Keo lá liềm điều tra có sinh trưởng đường kính gốc bằng 3,25 cm hoặc nhỏ hơn (3rd Qu.:3.250); có 50% đối tượng có sinh trưởng đạt 2,67 cm hoặc nhỏ hơn và có 25% đối tượng có sinh trưởng đường kính gốc đạt 2,147cm hoặc nhỏ hơn (1st Qu.:2.147).

Để  kiểm tra thống kê về chỉ tiêu sinh trưởng đường kính gốc cây Keo lá liềm ở 04 CTTN có khác nhau rõ rệt hay không (có ý nghĩa thống kê với mức độ tin cậy 95%)?  Ta sử dụng phân tích phương sai (ANOVA) để kiểm tra.
Trong R có thể sử dụng lệnh như sau:

> stump=aov(stump_diameter~CTTN)
> summary(stump)
Kết quả như sau:
             Df Sum Sq Mean Sq F value  Pr(>F)  
CTTN          3   7.67   2.555   4.413 0.00482 **
Residuals   243 140.70   0.579                  
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Kết quả cho thấy, trị số pvalue = 0,00482 < 0,05 (Ft = 4,413 > Flt = 2,06), tức là có sự khác biệt có ý nghĩa thống kê với mức độ tin cậy 95% giữa các CTTN về sinh trưởng đường kính gốc của cây Keo lá liềm. Tuy nhiên, kết quả không cho ta biết sự khác biệt giữa công thức nào với công thức nào? Ta có 06 nhóm: ĐC-CT3, ĐC-CT2, ĐC-CT1, CT3-CT1, CT3-CT2 và CT2-CT1. Vậy câu hỏi đặt ra là sự khác biệt có ý nghĩa thống kê về giữa nhóm công thức nào?
Để trả lời câu hỏi này, chúng ta có thể sử dụng phân tích hậu định, tức là phân tích hậu định trong phân tích phương sai.

Tuy nhiên, vấn đề đặt ra hiện nay là có nhiều phương pháp phân tích hậu định như: Fisher’s method (LSD), Bonferroni’s method, Duncan’s mutiple range test, Scheffe’, Tukey’s Honest Significant Difference, Dunnett’s test... Vậy phương pháp nào thích hợp nhất?
Trong phạm vi bài viết mình có sử dụng phương pháp Tukey’s Honest Significant Difference (TukeyHSD) trong R để kiểm tra. Phương pháp TukeyHSD được xem là một trong những phương pháp thích hợp nhất hiện nay trong phân tích hậu định nói chung giữa nhiều nhóm nghiên cứu.

Kết quả như sau:

> stump=aov(stump_diameter~CTTN)
> TukeyHSD(stump)

  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = stump_diameter ~ CTTN)

$CTTN
                diff         lwr        upr     p adj
CT 2-CT 1 -0.2674558 -0.63761365 0.10270205 0.2441079
CT 3-CT 1  0.0912766 -0.25175065 0.43430384 0.9014797
DC-CT 1   -0.3787234 -0.91386696 0.15642015 0.2614210
CT 3-CT 2  0.3587324  0.05906615 0.65839864 0.0116606
DC-CT 2   -0.1112676 -0.61970717 0.39717196 0.9420240
DC-CT 3   -0.4700000 -0.95904156 0.01904156 0.0646052

Kết quả cho thấy, chỉ có CT3-CT2 là có sự khác biệt có ý nghĩa thống kê với độ tin cậy 95% về chỉ tiêu sinh trưởng đường kính gốc. Các so sánh còn lại chưa có sự khác biệt có ý nghĩa thống kê (giá trị pvalue > 0,05). Theo đó, đường kính gốc ở CT3 cao hơn có ý nghĩa 0,36cm, dao động từ 0,06cm đến 0,66cm so với CT2.
Ngoài ra, chúng ta có thể so sánh sự khác biệt đó bằng biểu đồ với lệnh sau:

> plot(TukeyHSD(stump), ordeder=T)

Kết quả hình trên có thể giải thích như sau: Trên biểu đồ cho thấy những cặp đôi CT nào không cắt đường giá trị 0,0 (nét đứt) thì cặp đôi so sánh đó có ý nghĩa thống kê, tức là lệch hẳn về phía (âm, dương) của đường giá trị. Ta thấy, chỉ có CT3-CT2 không cắt ngang đường nét đứt, tức là có sự khác biệt có ý nghĩa thống kê. Còn lại là không có sự khác biệt có ý nghĩa thống kê.

chủ đề

Ăn của rừng bài báo khoa học bản quyền bành trướng Bảo vệ cây là bảo vệ chính mình biến đổi khí hậu Biển Đông Biết sai vẫn cứ làm biểu đồ biểu đồ hộp biểu đồ sai số chuẩn Biểu đồ tương quan Biểu đồ với nhãn bon-sai boxplot buoc-dau-nghien-cuu-khoa-hoc but-ky-doi-toi Cái tài Cái tâm Cái tầm canh tác đất dốc Cây xanh đô thị Cha chung không ai khóc cha nào con nấy Chân thiện mỹ chân trong chân ngoài chạy chức chạy quyền Che chở Chết toàn tập chọn cách ta sống chữ tín chuyện giờ mới kể có vấn đề Cơm áo gạo tiền Con cháu các cụ con người biến thái Con ông cháu cha công nghệ 4.0 correlation matrix corrgram corrplot Cứ đi rồi sẽ tới cuộc cách mạng 4.0 Đam mê đàn gảy tai trâu danh dự danh xưng phù phiếm Đạo đức sống đào tạo sau đại học Đạo văn Đấu tranh sinh tồn day-do Đẹp trong tâm hồn Đi tắt đón đầu dở khóc dở cười đọc nghe nhìn và cảm nhận Dồn điền đổi thửa Động lực dựa vào nhau mà sống error bar plot GGalyy ggcorplot ggExtra ggiraph ggplot2 ggrepel ggthemes Giáng sinh Giáo dục giàu nghèo giục tốc bất đạt Góc quê gridExtra Hài lòng Hai mặt một lời hãy là chính mình hãy sống có trách nhiệm hơn hèn nhát Hiệu sau ứng bão hiệu ứng domino formosa Hiệu ứng sau bão Hòa cả làng học giả bằng thật hoc-lam-tho hoc-r-moi-ngay Ích kỷ KH&CN khả năng Khoán chi Không lối thoát Kiểm định thống kê kỹ năng mềm Kỷ niệm vùng miền Label lan rừng Lão Hạc thế kỷ 21 Liêm chính lính đánh thuê Lợi dụng lợi ích nhóm lừa trên gạt dưới lười suy nghĩ Lương thiện giả vờ Lương y Ma trận tương quan Mẹ Miền cát trắng miền đất hứa Mộc Châu món ăn địa phương Mùa gặt Mục đích sống Mường La Nghịch lý chất lượng - số lượng Nghiên cứu khoa học Ngồi chơi xơi nước Nhân cách nhu cầu Những cung đường tôi đã qua NN&PTNT phân cấp sinh trưởng phân tích hậu định phan-bien-xa-hoi plot3D psych Quán Nha R Rừng ngập mặn rước hổ về nhà rvg sach-hay SARS-CoV-2 sau-luy-tre-lang sciplot Số cây Số liệu trống không Sông Châu sống chết mặc ai sức ỳ sức ỳ bản thân suy thoái Tầm lùn tâm sự tâm sự buồn thảm họa formosa thảm họa môi trường tham nhũng Thân cô thế cô thắng cố ngựa Thăng trầm Thấy vậy mà không phải vậy Thế cây Thế cây cổ Thế cây thế người Thông điệp cuộc đời Thống kê mô tả Thông tư Thước đo lòng người Thủy điện Tiên trách kỷ hậu trách nhân Tình bạn cao đẹp Tình người Tố chất làm khoa học tội đếch gì mà phải ghét ai Tôi sợ giầu lắm track changes Trải nghiệm tre già măng mọc trở mặt Trung thực tư duy Tự sự Tư tưởng thụt lùi tuy duy nhiệm kỳ Ứng dụng R trong lâm nghiệp Văn hóa cảm ơn Văn hóa giao thông văn hóa ngầm Văn hóa xin lỗi Xấu khen đẹp chê Xỏ nhầm giầy xoay đầu đổi đít Ý tưởng
Powered by Blogger.

Disqus Shortname

Widget Recent Post No.

Widget Random Post No.

Widget Recent Comment No.

PageNavi Results No.

Labels Max-Results No.

Comments system

Contact Form

Name

Email *

Message *

bài đăng phổ biến

số lượt ghé qua trang blog

Bài đăng nổi bật

Thế cây thế người

T hế trong CÂY CẢNH thể hiện các chi tiết về CẤU TRÚC ở mọi phương diện, đa góc nhìn (trên dưới trái phải ngang dọc), trong đ...

Bài đăng phổ biến

bài xem nhiều nhất